Hacker News Front Page · jasonjmcghee ·
AlphaNIST
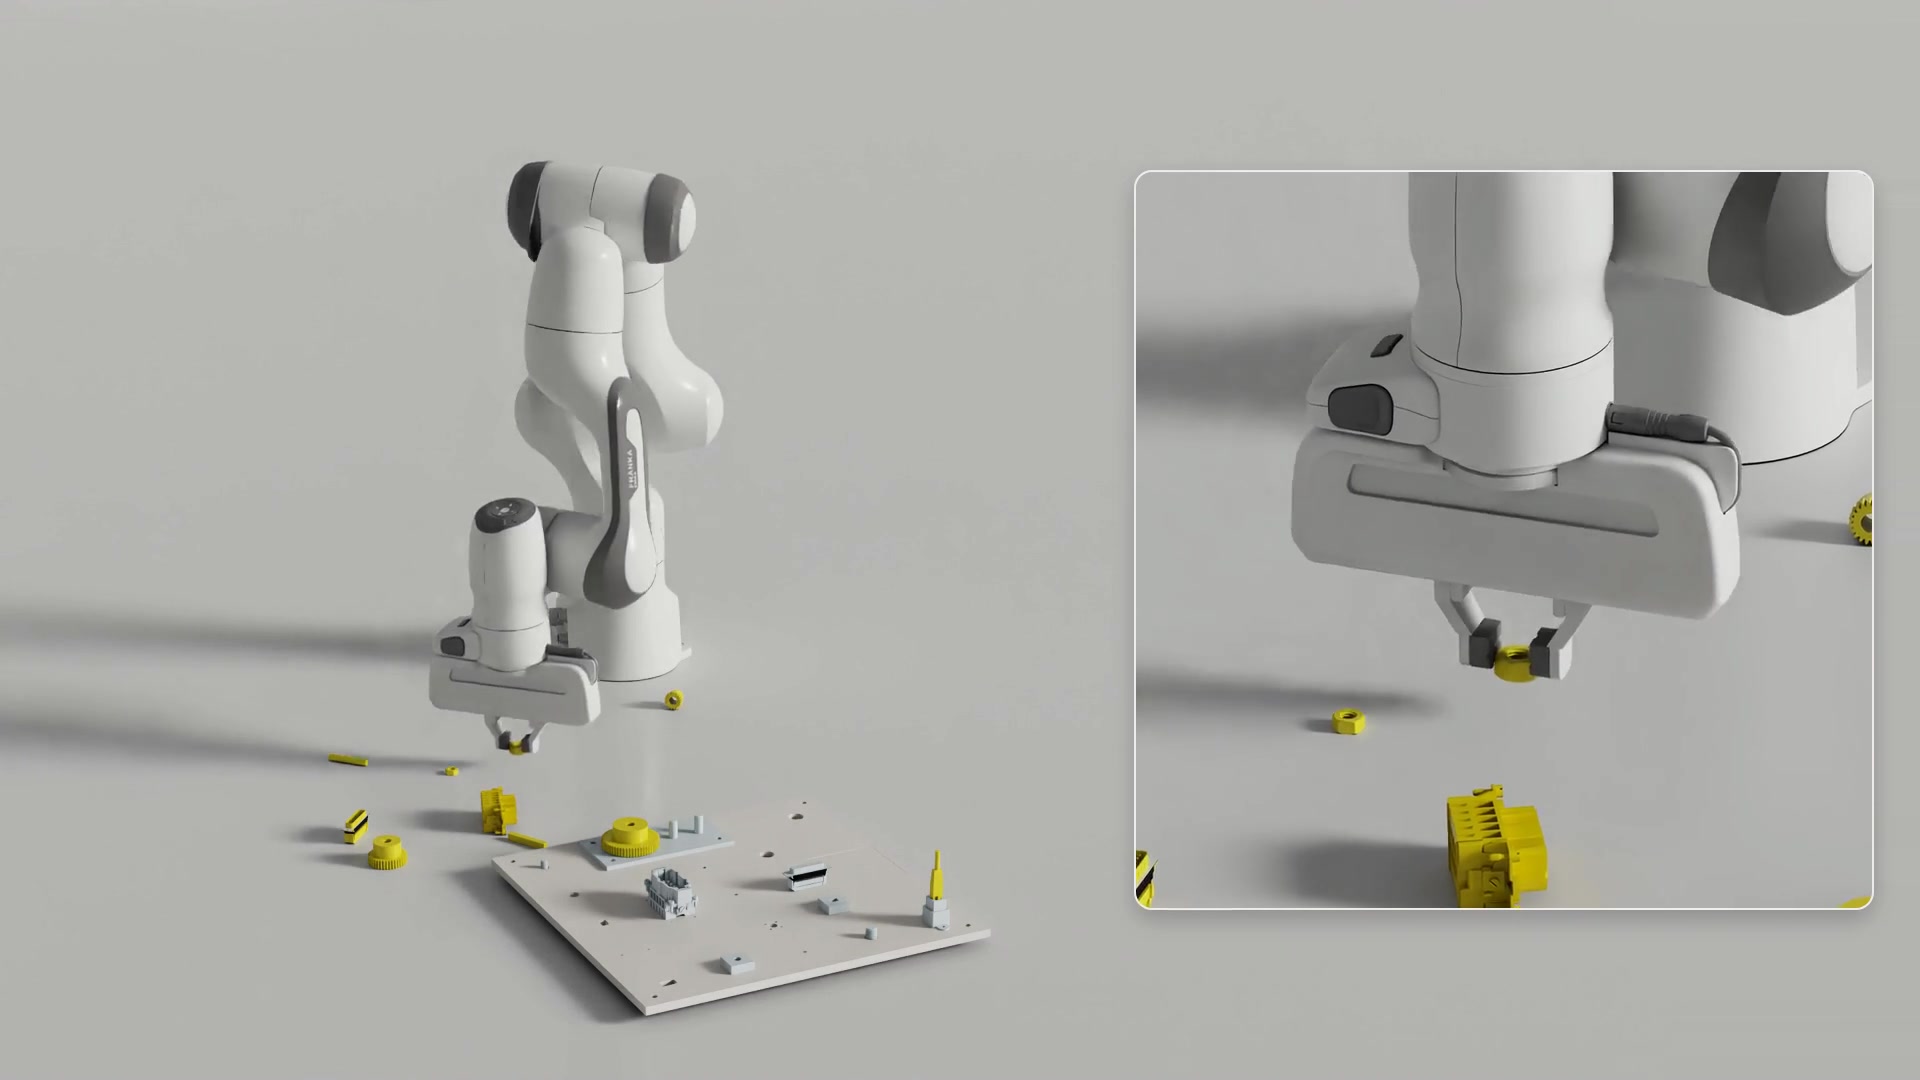
AlphaNIST plantea que los robots pueden aprender tareas de ensamblaje complejas a partir de recompensas binarias de éxito, sin recibir instrucciones sobre cada maniobra. Una sola política se entrena para completar veinte ensamblajes distintos mediante experiencias diversas en simulación, incluidos estados iniciales parciales y piezas ya sujetas, pero no demostraciones. El muestreo guiado por el éxito concentra la práctica en estados que la política resuelve aproximadamente la mitad de las veces, sin dejar de explorar los demás.
Learning dexterity and coordination for robotic assembly in simulation, with binary task rewards and no prescribed manipulation stages.