Hacker News Front Page · amrrs ·
Embedding Gemma Transcribe
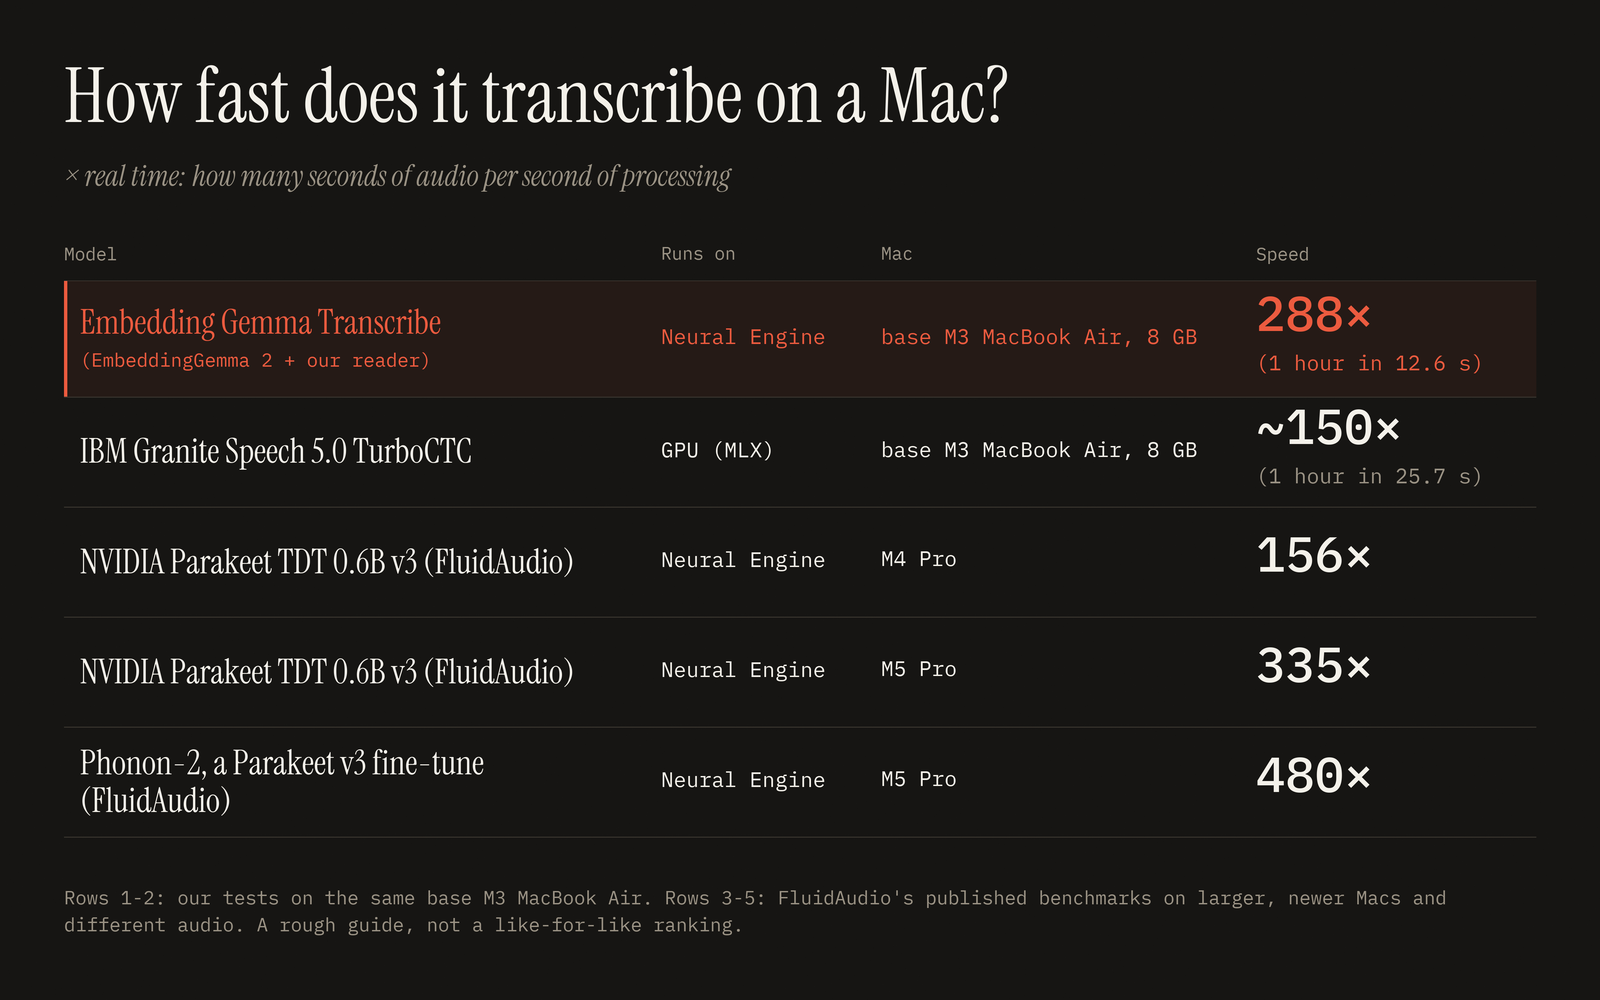
Embedding Gemma Transcribe adapta el modelo multimodal de embeddings EmbeddingGemma 2 para transcribir audio: un pequeño lector convierte fragmentos de audio en palabras del espacio de texto del modelo, y otro modelo añade puntuación y mayúsculas. En una MacBook Air M3 básica, procesa una hora de audio en 12,6 segundos y funciona completamente en el dispositivo; su tasa de error de palabras actual es de alrededor del 5 %, frente al 2–3 % de los modelos de voz líderes.
An embedding model, turned into a speech-to-text model. An hour of audio in about 13 seconds on a base MacBook Air, on device.