Hacker News Front Page · Cartesia Research ·
From Tokens to Bytes I: Scaling Hierarchical Networks
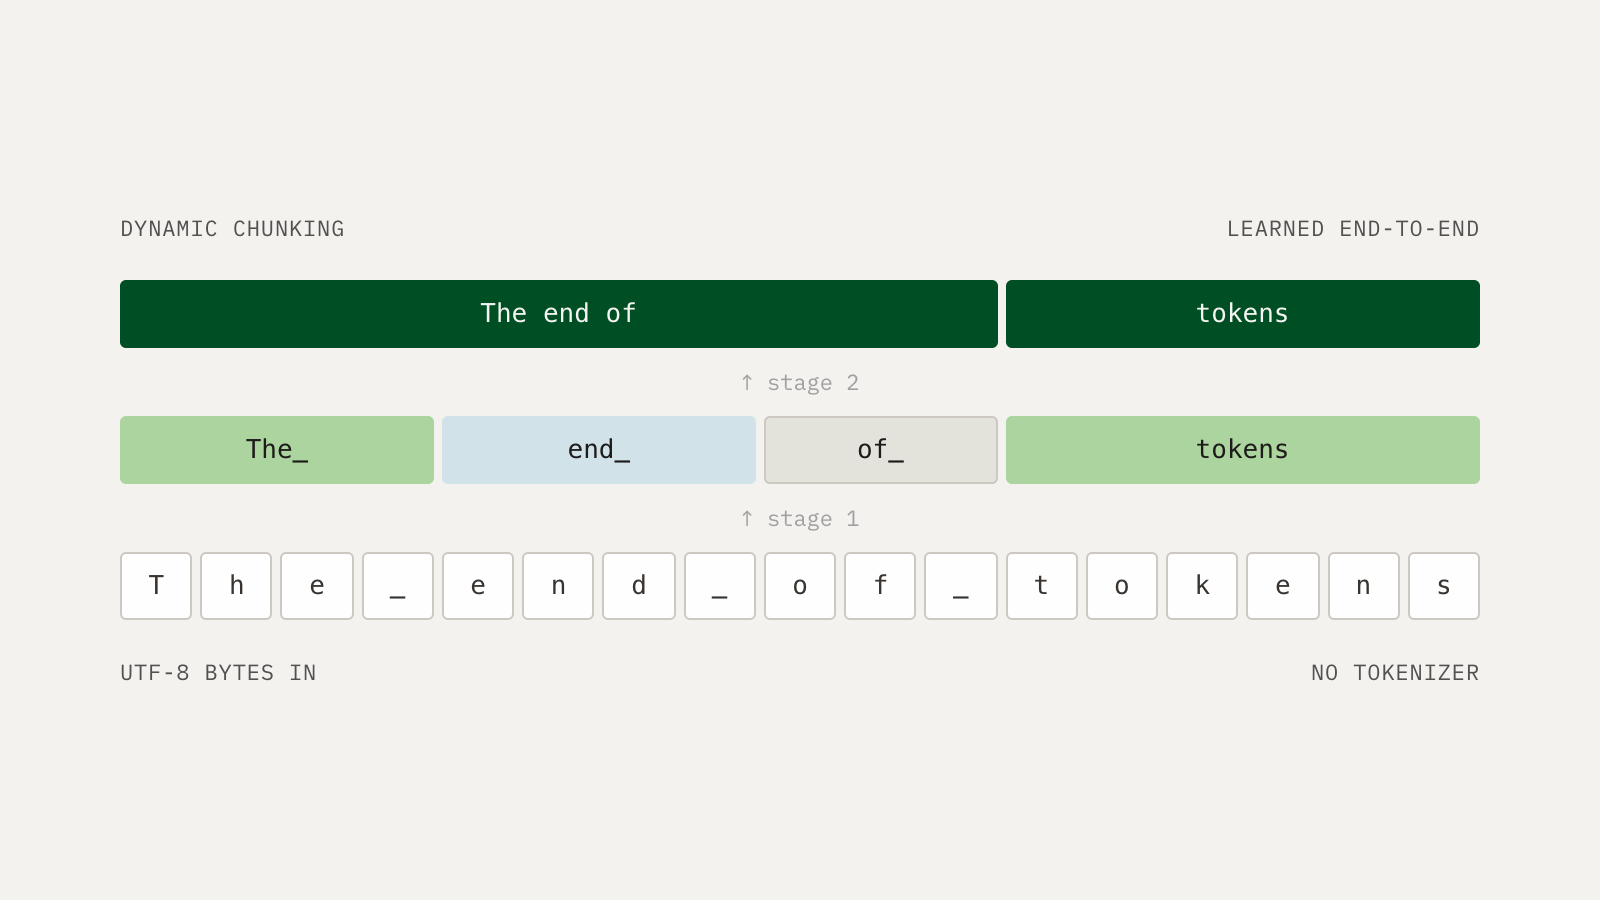
Cartesia presenta los H-Nets, una arquitectura que aprende a agrupar bytes en unidades jerárquicas durante el entrenamiento, en lugar de depender de un tokenizer fijo como BPE. En pruebas controladas, los modelos lograron una eficiencia de cómputo 1,28 veces mayor en validación y cerca de 2 veces mayor en evaluaciones posteriores; las mejoras llegaron a una mediana de 3,10 veces en lenguajes de programación fuera del conjunto de entrenamiento. El artículo también informa resultados prometedores en ADN y visión, aunque señala que comparar justamente el cómputo entre modelos sigue siendo un problema metodológico abierto.
A newer generation of H-Nets learns directly from raw bytes, and matches an open-source 3B Transformer with 10x less compute and data.