Hacker News Front Page · ThibWeb ·
One month coding with GLM 5.3 Flash
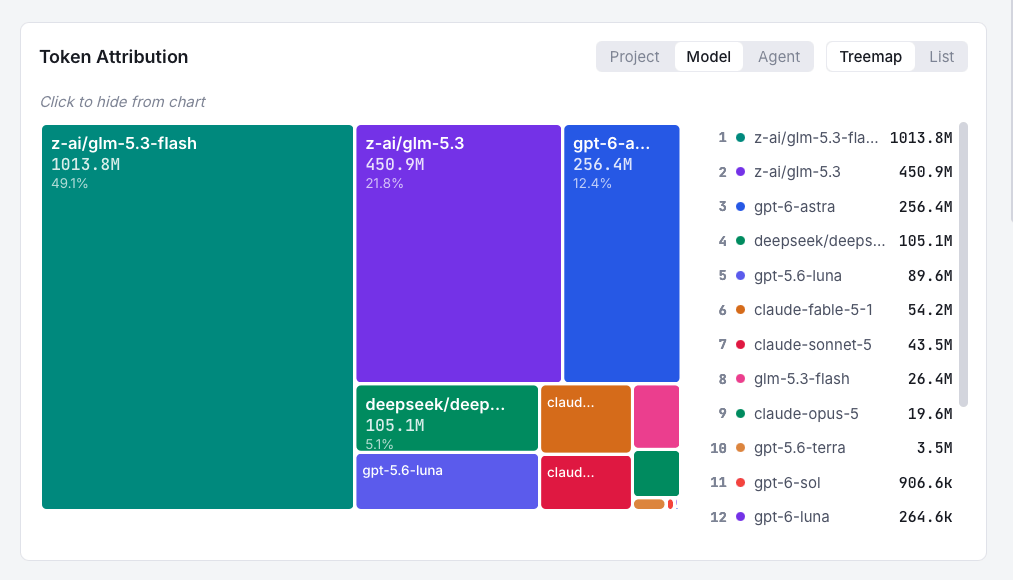
El equipo de Wagtail pasó un mes experimentando con GLM 5.3 Flash como modelo principal de IA, pero solo alcanzó 50% de uso de dicho modelo. El análisis detalla que gastar 450M tokens ($150, 5kWh de energía) en prototipado no estructurado ("vibe coding") del servidor MCP, sumado a cambios forzados entre proveedores por falta de capacidad y la necesidad de experimentar constantemente con nuevos modelos, consumió más recursos de lo planeado. Los autores reconocen que podrían haber logrado resultados similares con 5 veces menos costo aplicando más disciplina en la selección de modelos y patrones multi-agente, y proponen para futuros ciclos medir constantemente energía y gasto, presupuestar la experimentación y usar técnicas de orquestación de agentes más eficientes.
Reporting on 2B tokens of AI usage and what shapes model selection and cost